> ## Documentation Index
> Fetch the complete documentation index at: https://docs.tryprofound.com/llms.txt
> Use this file to discover all available pages before exploring further.
# Web Page Scrape
> Recupera el contenido de una sola página web en un formato limpio y estructurado
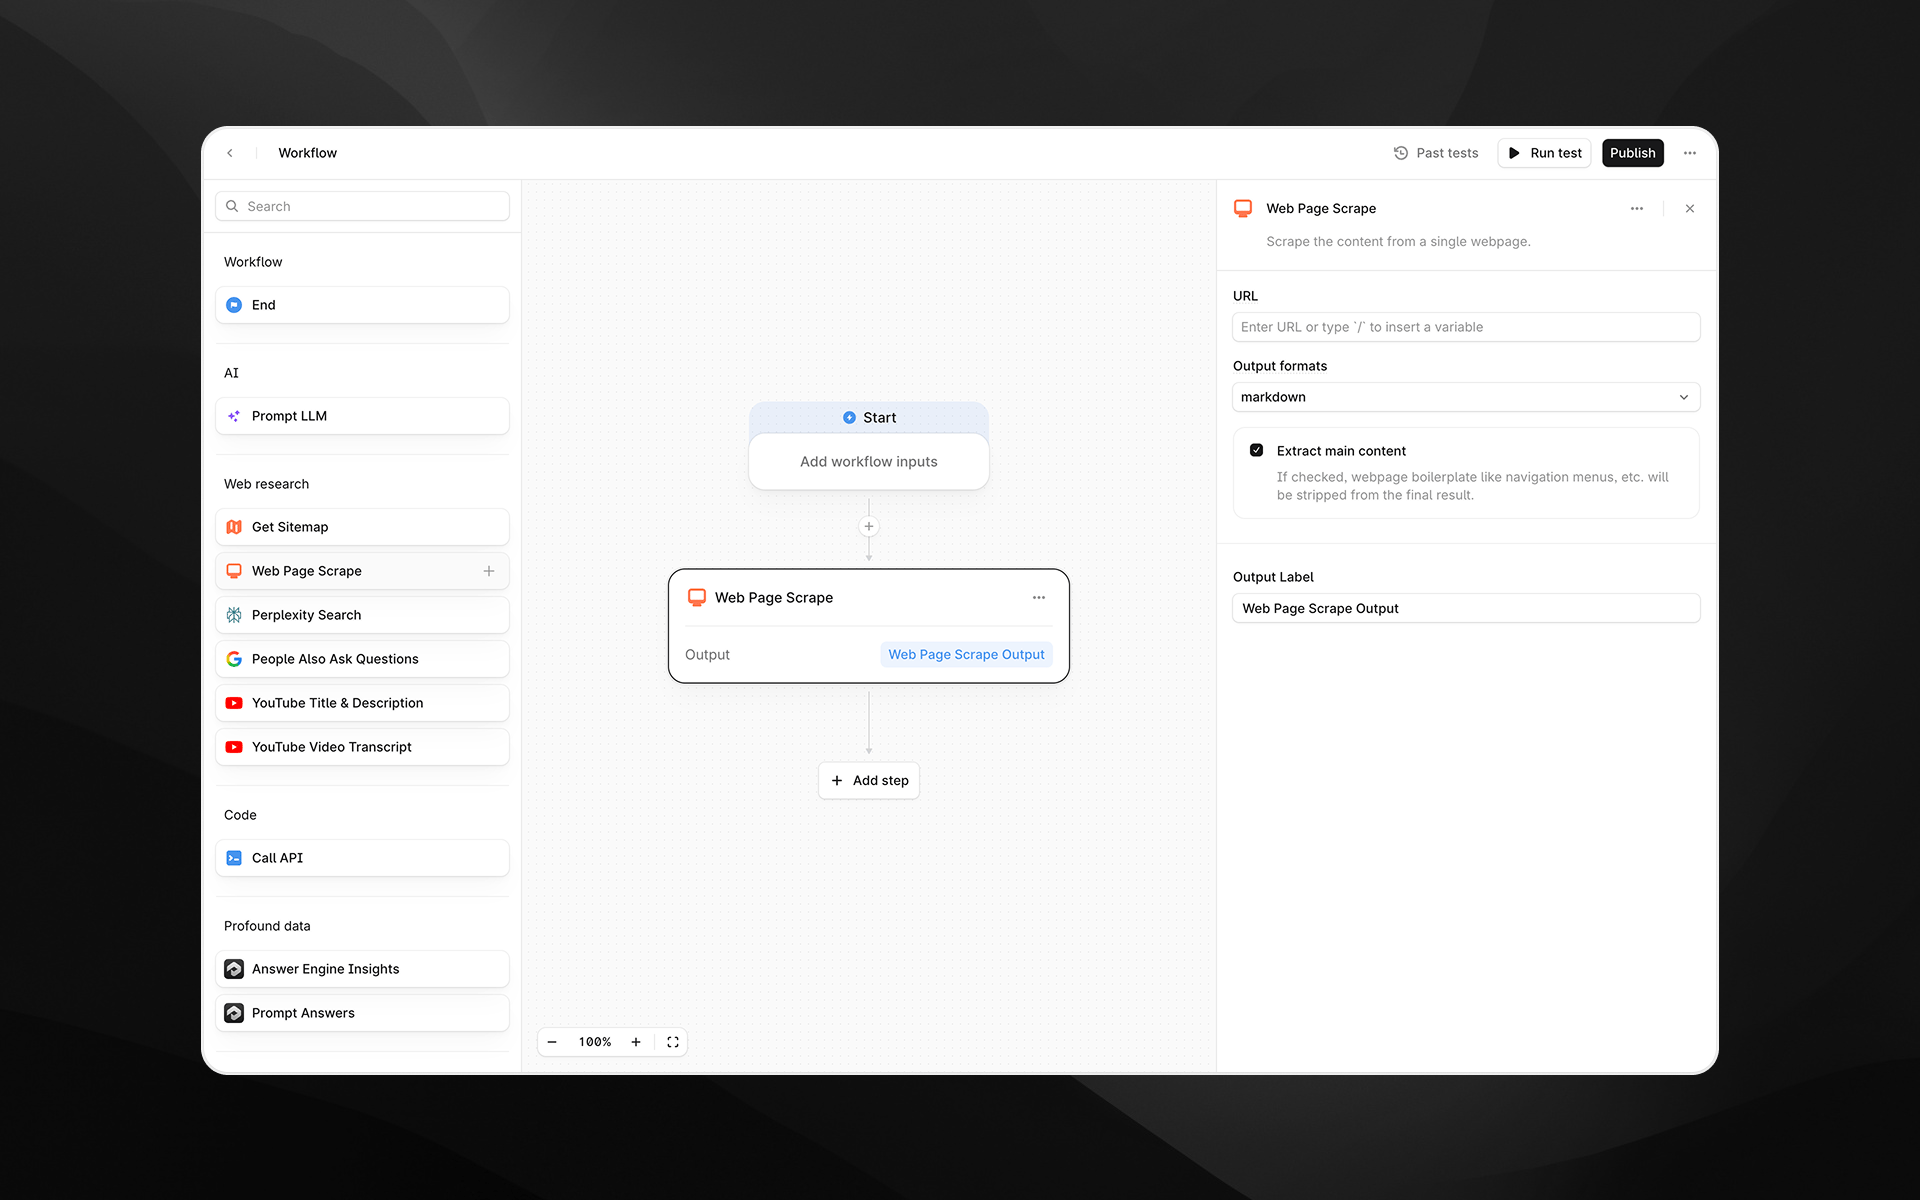
El nodo **Web Page Scrape** recupera el contenido de una sola página web y lo devuelve en un formato limpio y estructurado. Usa este paso cuando necesites analizar, resumir o extraer información de cualquier URL de acceso público.
Este nodo admite salidas tanto en HTML sin procesar como en markdown limpio, lo que lo hace útil para el procesamiento posterior con IA en pasos Prompt LLM o para crear [Agents](/es/agents/about) de investigación estructurados.
 Consulta [Primeros pasos con Agents](/es/agents/getting-started) para aprender a agregar este nodo a un Agent.
## Cuándo usar este nodo
Usa Web Page Scrape para tareas como:
* Recopilar contenido de artículos, páginas de destino, publicaciones de blog o documentación
* Extraer texto para resúmenes o análisis de la competencia
* Obtener contenido estructurado para usarlo en prompts de LLM posteriores
* Normalizar el contenido de páginas web antes de incorporarlo a otros pasos del Agent
## Configuración del nodo
Al seleccionar el nodo Web Page Scrape se abre su panel de configuración en el lado derecho del Agent Builder. Este nodo incluye los siguientes campos.
### URL (obligatorio)
Introduce la URL de la página web que quieres extraer.
Puedes:
* Pegar una URL estática, o
* Insertar una variable escribiendo `/` para hacer referencia a entradas del Agent o salidas de pasos anteriores
### Render Output As
Elige el formato del contenido extraído. Opciones disponibles:
* **Markdown**: devuelve texto limpio y legible, adecuado para el procesamiento con LLM
* **HTML**: devuelve la estructura HTML de la página
Se recomienda Markdown para la mayoría de las tareas con IA, mientras que HTML es útil cuando las etiquetas, la estructura o los metadatos son importantes.
### Extract main content
Cuando está activado, Profound intenta eliminar elementos de navegación, anuncios, pies de página, texto repetitivo y otro contenido no esencial. Por lo general, esto da como resultado una salida más limpia centrada en el artículo o el cuerpo de texto principal.
Desactiva esta opción si necesitas el contenido completo de la página sin filtrar.
### Output Label
Proporciona una etiqueta descriptiva para la salida de este paso. La etiqueta se convierte en el nombre de variable al que harás referencia en nodos posteriores del Agent.
Ejemplos:
* `page_content`
* `scraped_markdown`
* `raw_html`
## Salida
Este nodo devuelve una única salida de texto con el contenido extraído de la página en el formato seleccionado. La salida se puede usar en:
* Pasos Prompt LLM
* Nodos adicionales de investigación o análisis
* Llamadas a API
* Cualquier paso de transformación posterior
## Ejemplos de uso
### 1. Extraer y resumir una página web
1. Agrega un paso **Web Page Scrape** y establece la URL de la página que quieres analizar.
2. Elige **Markdown** como formato de salida.
3. Agrega un paso [Prompt LLM](/es/agents/nodes/prompt-llm) que haga referencia al contenido extraído:
```text wrap theme={null}
Summarize the key ideas from the following content:
{{web_page_scrape.output}}
```
### 2. Extraer datos estructurados de HTML
1. Extrae la página usando el formato **html**.
2. Pasa el HTML a un paso [Prompt LLM](/es/agents/nodes/prompt-llm) con instrucciones de extracción:
```text wrap theme={null}
Extract all product names and prices from the following HTML. Return JSON.
```
## Buenas prácticas
* Usa la **salida en Markdown** para obtener el texto más limpio y listo para IA.
* Activa **Extract main content** cuando trabajes con páginas de tipo artículo.
* Si la extracción falla, confirma que la URL es de acceso público y no requiere autenticación.
* Mantén etiquetas de salida claras y descriptivas para simplificar las referencias posteriores.
## Solución de problemas
### El contenido extraído está vacío o incompleto
Esto puede ocurrir si la página depende en gran medida del renderizado en el lado del cliente o usa protección contra scraping. Prueba a cambiar a la salida **html** para obtener contenido más en bruto.
### Aparece texto repetitivo en la salida
Asegúrate de que **Extract main content** esté activado para reducir el contenido sobrante.
### La URL contiene variables que no se resuelven
Escribe `/` para insertar variables compatibles y evitar nombres de parámetros que no coincidan.