> ## Documentation Index
> Fetch the complete documentation index at: https://docs.tryprofound.com/llms.txt
> Use this file to discover all available pages before exploring further.
# Prompt LLM
> Agent 内でカスタムプロンプトを使って大規模言語モデルでテキストを生成します
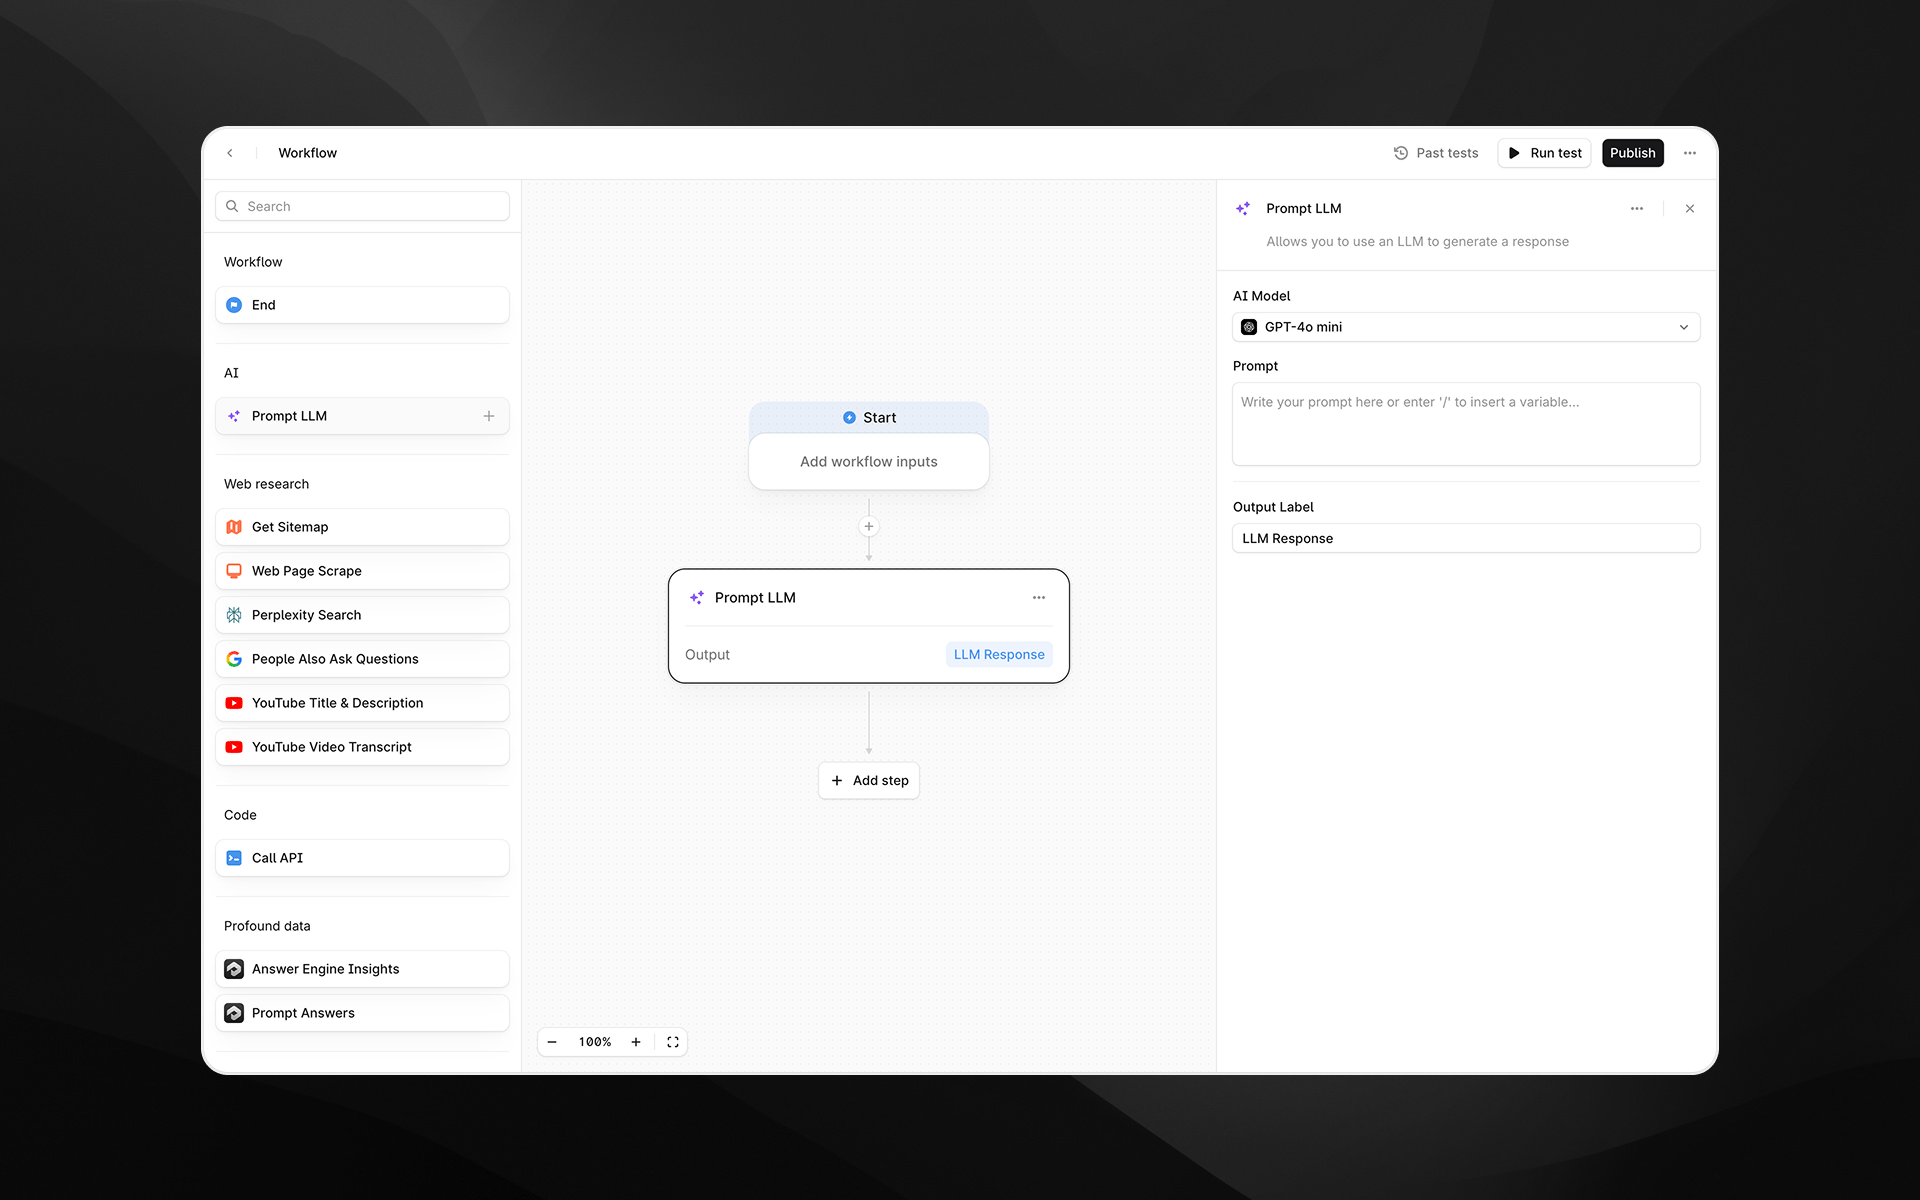
**Prompt LLM** ノードを使用すると、大規模言語モデル(LLM)でテキストを生成できます。このステップは、カスタムプロンプトに基づく AI 生成の要約、分類、書き換え、抽出、その他の変換が必要な場合に使用します。
前のステップの変数をプロンプトに挿入できるため、[Agent](/agents/about) の入力と出力に応じて変化する動的な応答を生成できます。
 このノードを Agent に追加する方法については、[Agents を始める](/ja-jp/agents/getting-started)をご覧ください。
## このノードを使用するタイミング
Prompt LLM ノードは、次のようなタスクに使用します。
* 検索結果やスクレイピングしたコンテンツの要約
* 後続処理のための応答や構造化出力の下書き
* テキストからのエンティティやインサイトの抽出
* 特定のオーディエンスや形式に合わせたコンテンツの書き換え
* 非構造化データの構造化フィールド(JSON、箇条書きなど)への変換
## ノードの設定
Prompt LLM ノードを選択すると、Agent Builder の右側に設定パネルが開きます。このノードには次の設定フィールドがあります。
### AI Model
出力の生成に使用するモデルを選択します。
Agent の設計中はいつでもモデルを切り替えられます。選択したモデルによって、出力の品質、速度、コストが決まります。
### Prompt
モデルに従わせたい指示を記述します。これは LLM の動作を決定する中核となる入力です。
次のことができます。
* プレーンテキストで指示を入力する
* Agent の入力を参照する
* / を入力して変数ピッカーを開き、前のノードの変数を挿入する
プロンプトは短くても詳細でもかまいません。最良の結果を得るには、トーン、構成、出力形式、制約について明示的に指示してください。
より良いプロンプトを書くためのヒントについては、[Prompt LLM のベストプラクティス](/agents/how-tos/prompt-llm-best-practices)ガイドをご覧ください。
### Use Skill
このオプションをオンにすると、既存のプロダクトスキルをテキスト生成に適用します。
### Use Knowledge Base
LLM にタスクで Knowledge Base の情報を使用させたい場合は、このオプションをオンにします。オンにしたら、ドロップダウンから Knowledge Base 全体を選択するか、取得設定メニューで特定のフォルダーを選択します。
Knowledge Base の詳細については、[Knowledge Bases and Brand Kits](/context-manager/knowledge-bases-and-brand-kits) をご覧ください。
### Structured Output
LLM の応答の JSON スキーマを定義します。フィールドを追加し、データ型(string、number、boolean、list)を定義して、簡潔な説明を付けます。
これは Sheets を使用する場合に特に便利です。詳しくは [Sheets を始める](/ja-jp/sheets/getting-started)ガイドをご覧ください。
### Output Label
このステップの出力にわかりやすいラベルを入力します。指定したラベルが、後続の Agent ステップで参照できる変数名になります。
例:
* `analysis_summary`
* `buyer_intent_score`
* `cleaned_text`
## 出力
Prompt LLM ノードは、LLM の応答を含む 1 つのテキストまたは JSON 出力を生成します。この出力は、次のような後続ノードに渡すことができます。
* 追加の Prompt LLM ステップ
* API 呼び出し
* Profound のデータ処理ノード
* Iteration ノード
## 使用例
Profound の Agents で Prompt LLM ノードを使用する一般的な例を以下に示します。
### 1. スクレイピングしたウェブページを要約する
1. **Web Page Scrape** ステップを追加します。
2. **Prompt LLM** ノードを追加します。
3. プロンプトで、スクレイピングしたページのコンテンツを参照します。
```text wrap theme={null}
Summarize the key themes from the following webpage content in 5 bullet points:
{{web_page_scrape.content}}
```
4. Output Label を `summary` に設定します。
### 2. アンサーエンジンの結果からエンティティを抽出する
1. [**Profound データノード**](/ja-jp/agents/nodes/data/visibility-score) **** を使用して入力を収集します。
2. **Prompt LLM** ステップを追加して、構造化された情報を抽出します。
```text wrap theme={null}
Extract the brand mentioned in this answer and return JSON:
{"brand": ""}
Content: {{answer.text}}
```
3. 得られた JSON 出力を後続の条件分岐ロジックで使用します。
### 3. 特定のオーディエンス向けにコンテンツを書き換える
```text wrap theme={null}
Rewrite the following text for a B2B marketing leader, keeping it concise and professional:
{{input_text}}
```
## ベストプラクティス
* **明示的に指示する。** LLM は詳細な指示に対してより安定して応答します。
* **期待する形式を定義する。** 箇条書き、JSON、表、特定の言い回しを使って出力の構造を制御します。
* **必要なものだけを参照する。** タスクに必要でない限り、不必要に大きなコンテンツブロックを渡さないようにします。
* **出力にわかりやすい名前を付ける。** 適切なラベルを付けると、Agents の保守や再利用が容易になります。
## トラブルシューティング
### 出力が期待した形式になっていない
次のような明示的な指示を追加してください。
* 「JSON のみで回答してください。」
* 「箇条書きをちょうど 3 つ示してください。」
* 「説明は含めないでください。」
### プロンプトに変数が表示されない
Prompt フィールドにカーソルを置いた状態で `/` を入力すると、変数ピッカーが開きます。
### 出力が不完全または途中で切れているように見える
より大きなモデルに切り替えるか、より短く構造化された出力を求めるようにプロンプトを修正してください。