> ## Documentation Index
> Fetch the complete documentation index at: https://docs.tryprofound.com/llms.txt
> Use this file to discover all available pages before exploring further.
# Web Page Scrape
> 単一のウェブページのコンテンツを、整理された構造化形式で取得します
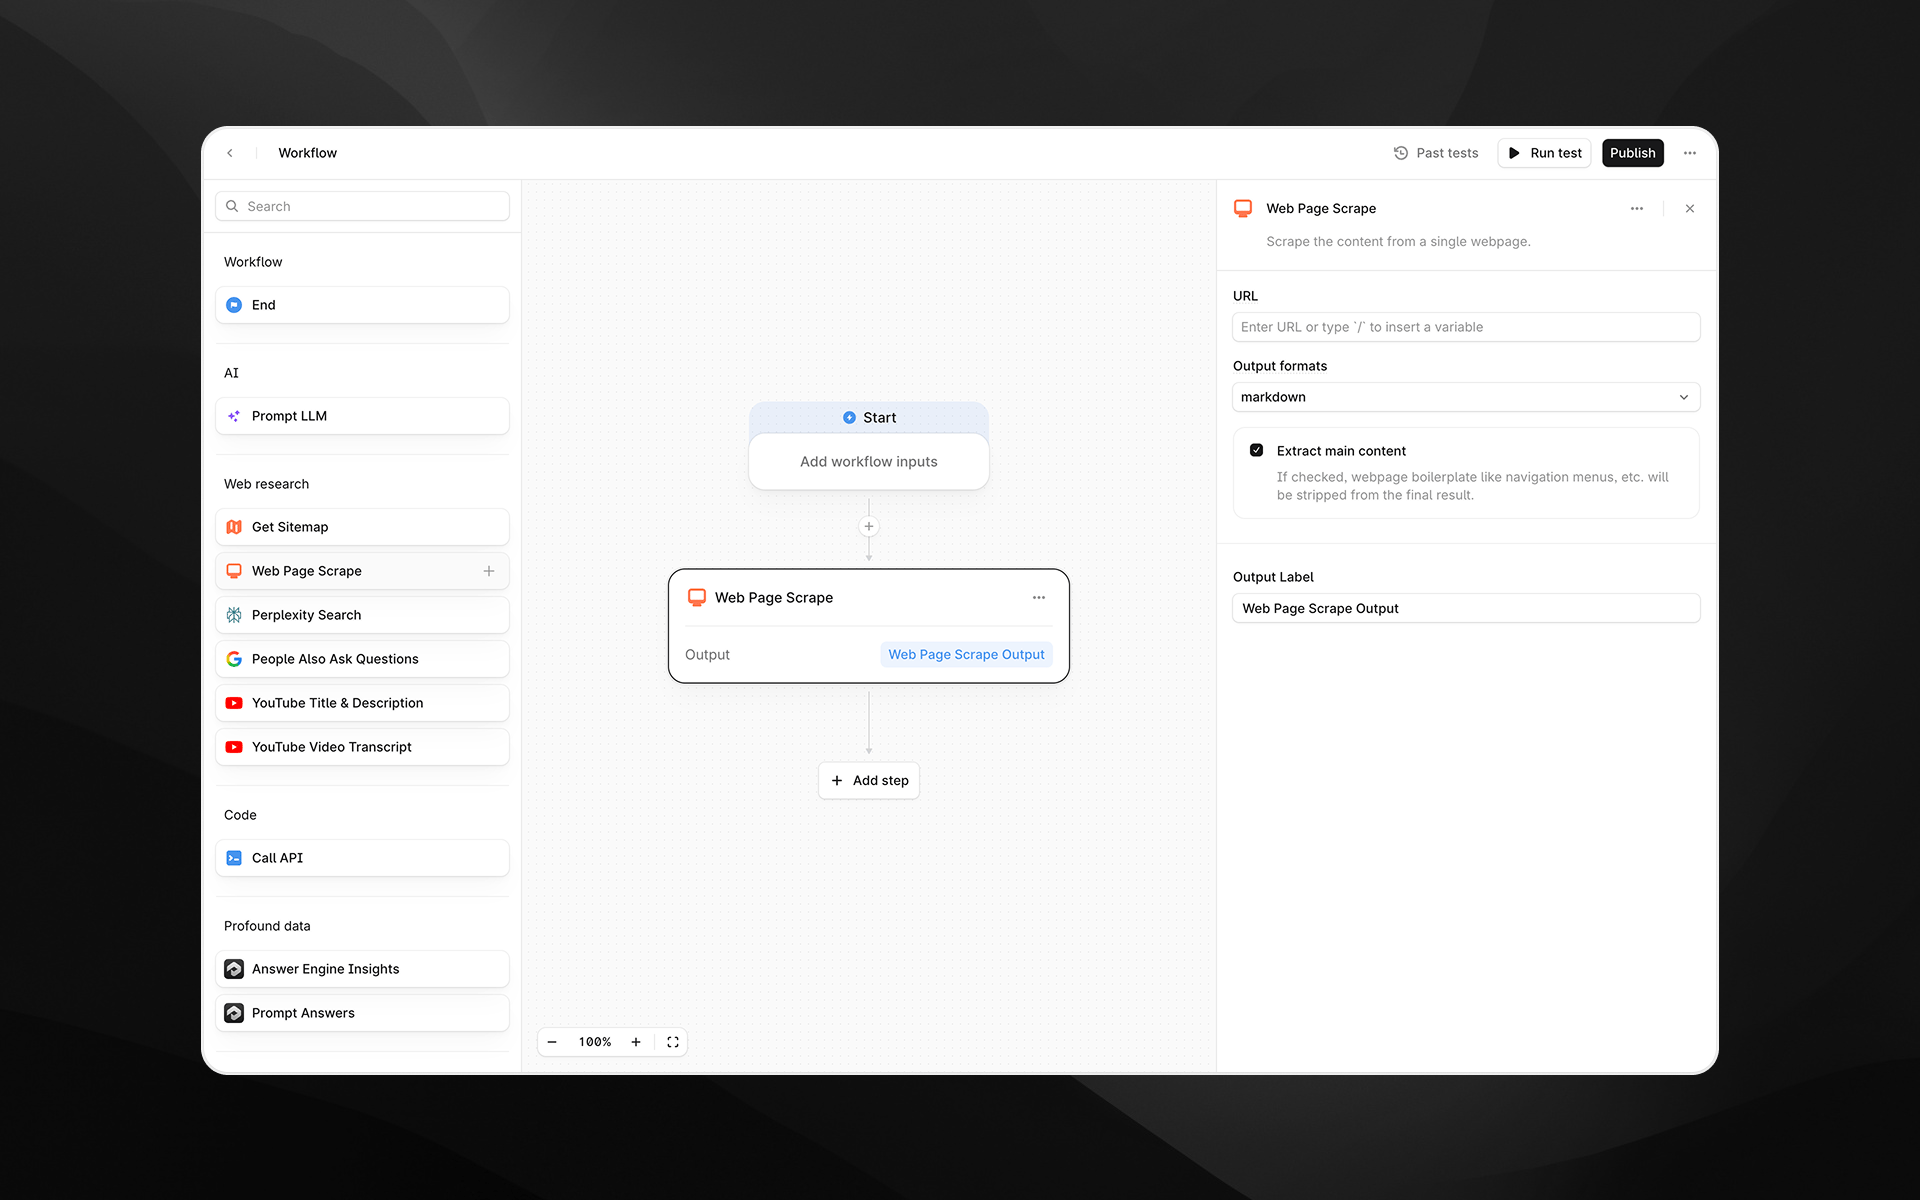
**Web Page Scrape** ノードは、単一のウェブページからコンテンツを取得し、整理された構造化形式で返します。このステップは、一般公開されている任意の URL から情報を分析、要約、または抽出する必要がある場合に使用します。
このノードは生の HTML と整理済みの Markdown の両方の出力に対応しているため、Prompt LLM ステップでの後続の AI 処理や、構造化されたリサーチ [Agents](/agents/about) の構築に役立ちます。
 このノードを Agent に追加する方法については、[Agents を始める](/ja-jp/agents/getting-started)をご覧ください。
## このノードを使用するタイミング
Web Page Scrape は、次のようなタスクに使用します。
* 記事、ランディングページ、ブログ投稿、ドキュメントからのコンテンツ収集
* 要約や競合分析のためのテキスト抽出
* 後続の LLM プロンプトで使用する構造化コンテンツの取得
* 他の Agent ステップに取り込む前のウェブページコンテンツの正規化
## ノードの設定
Web Page Scrape ノードを選択すると、Agent Builder の右側に設定パネルが開きます。このノードには次のフィールドがあります。
### URL(必須)
スクレイピングしたいウェブページの URL を入力します。
次のいずれかを行えます。
* 固定の URL を貼り付ける
* `/` を入力して変数を挿入し、Agent の入力や前のステップの出力を参照する
### Render Output As
スクレイピングしたコンテンツの形式を選択します。利用可能なオプション:
* **Markdown** – LLM 処理に適した、整理された読みやすいテキストを返します
* **HTML** – ページの HTML 構造を返します
ほとんどの AI タスクには Markdown をおすすめします。タグ、構造、メタデータが重要な場合は HTML が便利です。
### Extract main content
有効にすると、Profound はナビゲーション要素、広告、フッター、定型文、その他の主要でないコンテンツの除去を試みます。通常、記事本文やメインテキストに焦点を当てた、より整理された出力になります。
フィルタリングせずにページ全体のコンテンツが必要な場合は、このオプションを無効にしてください。
### Output Label
このステップの出力にわかりやすいラベルを付けます。このラベルが、後続の Agent ノードで参照する変数名になります。
例:
* `page_content`
* `scraped_markdown`
* `raw_html`
## 出力
このノードは、選択した形式でスクレイピングしたページのコンテンツを含む、1 つのテキスト出力を返します。この出力は次の用途に使用できます。
* Prompt LLM ステップ
* 追加のリサーチや解析ノード
* API 呼び出し
* 後続のあらゆる変換ステップ
## 使用例
### 1. ウェブページをスクレイピングして要約する
1. **Web Page Scrape** ステップを追加し、分析したいページの URL を設定します。
2. 出力形式として **Markdown** を選択します。
3. スクレイピングしたコンテンツを参照する [Prompt LLM](/ja-jp/agents/nodes/prompt-llm) ステップを追加します。
```text wrap theme={null}
Summarize the key ideas from the following content:
{{web_page_scrape.output}}
```
### 2. HTML から構造化データを抽出する
1. **html** 形式でページをスクレイピングします。
2. 抽出の指示とともに HTML を [Prompt LLM](/ja-jp/agents/nodes/prompt-llm) ステップに渡します。
```text wrap theme={null}
Extract all product names and prices from the following HTML. Return JSON.
```
## ベストプラクティス
* AI 処理に最適な整理されたテキストを得るには、**Markdown 出力**を使用してください。
* 記事形式のページを対象とする場合は、**Extract main content** を有効にしてください。
* スクレイピングに失敗した場合は、URL が一般公開されていて、認証を必要としないことを確認してください。
* 後続の参照をシンプルにするため、出力ラベルは明確でわかりやすいものにしてください。
## トラブルシューティング
### スクレイピングしたコンテンツが空または不完全
ページがクライアントサイドレンダリングに大きく依存している場合や、スクレイピング対策が施されている場合に発生することがあります。**html** 出力に切り替えて、より生に近いコンテンツを取得してみてください。
### 出力に定型文が含まれる
**Extract main content** が有効になっていることを確認して、不要な要素を減らしてください。
### URL に含まれる変数が解決されない
`/` を入力してサポートされている変数を挿入し、パラメーター名の不一致を避けてください。