> ## Documentation Index
> Fetch the complete documentation index at: https://docs.tryprofound.com/llms.txt
> Use this file to discover all available pages before exploring further.
# Get Sitemap ノード
> 公開されている任意の Web サイトの完全なサイトマップを作成します
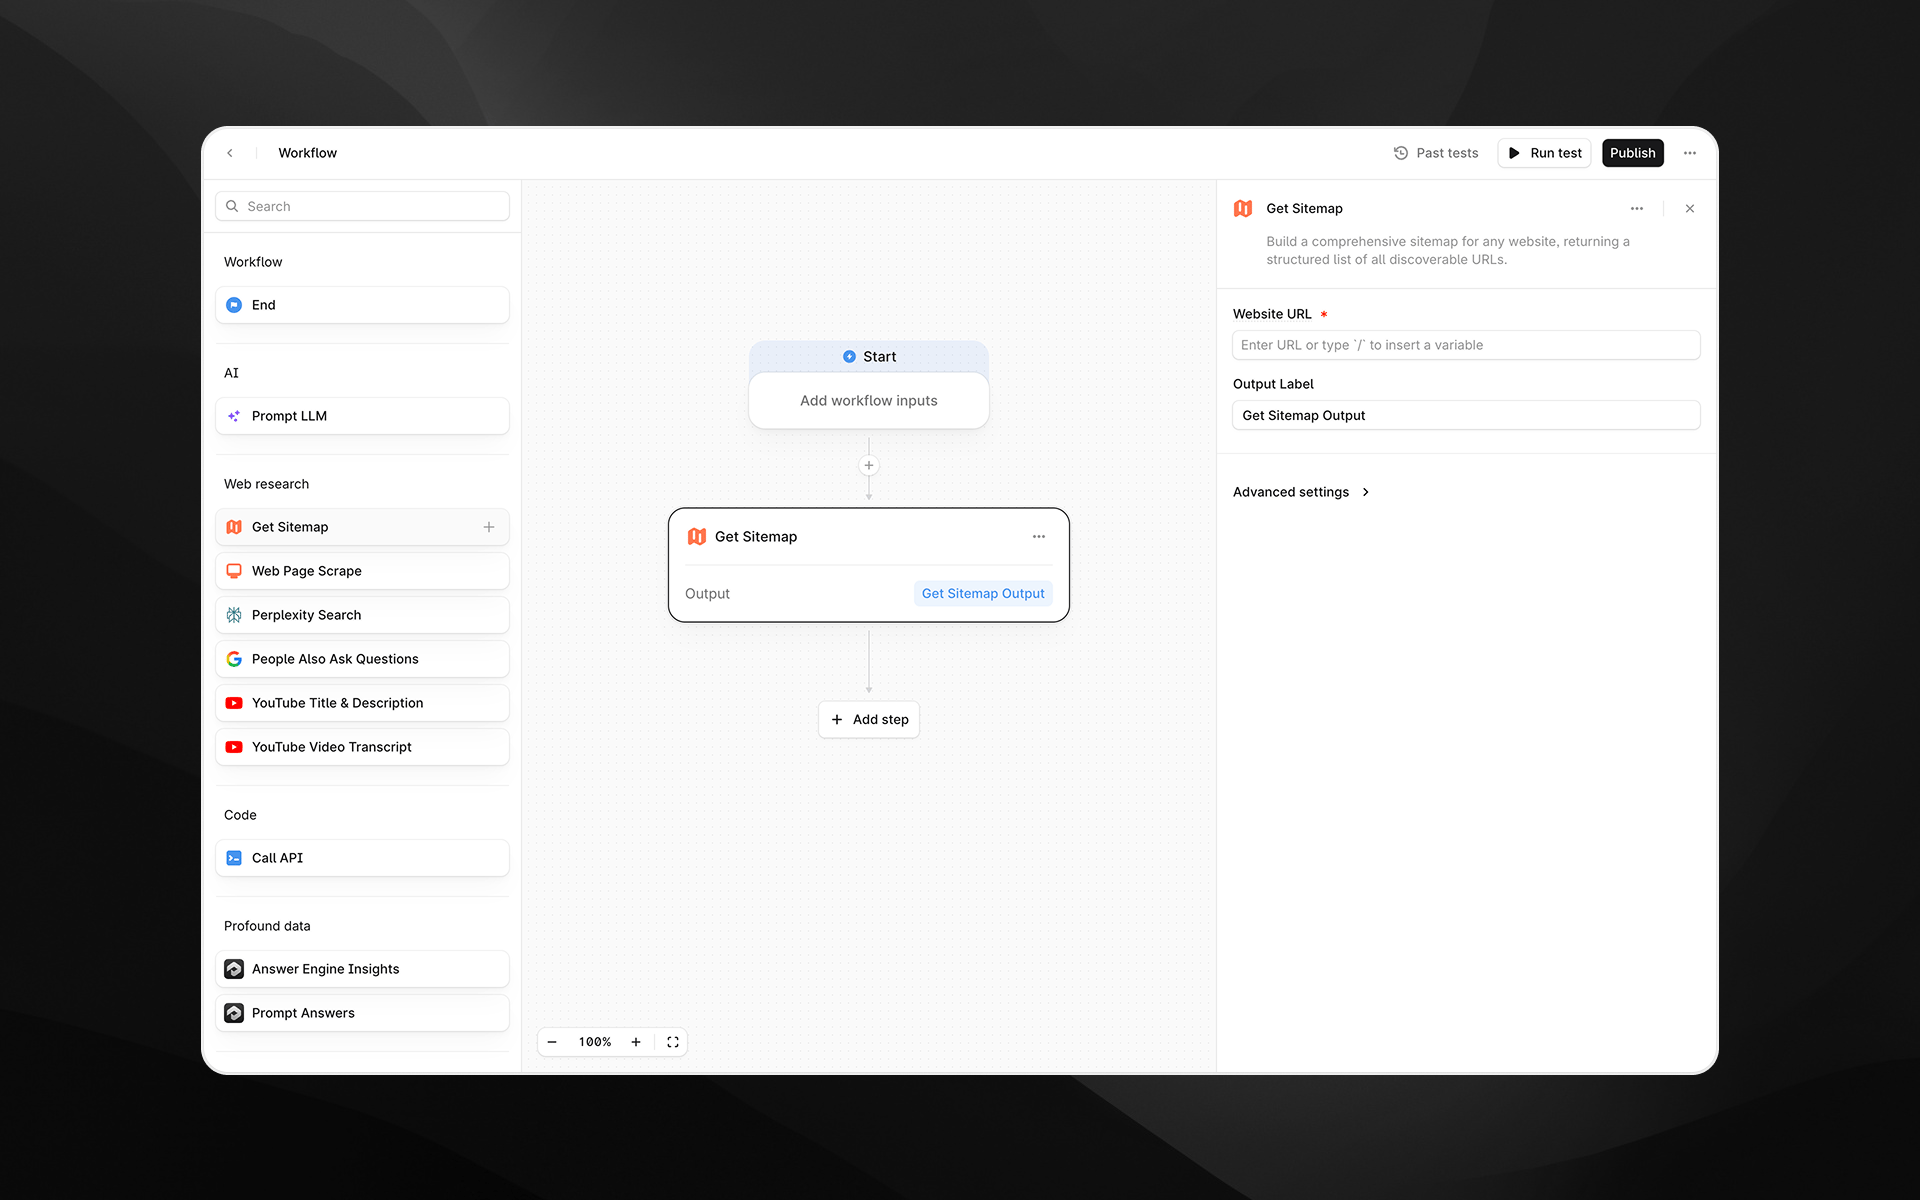
**Get Sitemap** ノードは、公開されている任意の Web サイトの包括的なサイトマップを作成します。検出可能なすべての URL を構造化されたリストとして返すため、サイトのコンテンツ全体を把握できます。
これは、リサーチ、コンテンツ監査、競合分析、コンテンツ計画、および大量の URL を後続の Workflow ステップに渡す場合に役立ちます。
内部的には、このノードは Firecrawl のサイトマップおよびサイトマッピング機能を使用してドメインをクロールし、重複を除いた整理済みの URL リストを返します。ただし、この処理は Profound 内で完全に抽象化されています。
 ## このノードを使用する場面
**Get Sitemap** は、次のような場合に使用します。
* 自社サイトまたは競合サイトのすべての URL を監査したい
* AEO のためのコンテンツギャップや機会を特定したい
* サイト全体を自動的に分析または要約する Workflow を構築したい
* 一括スクレイピング、一括インサイト、大規模なコンテンツリサーチのためのソース URL を取得したい
* 比較、クラスタリング、抽出のために複数の URL を LLM ステップに渡したい
* 技術的なレビューや SEO レビューを実施したり、サイト階層をマッピングしたりしたい
これは、AEO を意識したリサーチパイプラインを構築するための基盤となるノードです。
## ノードの設定
### Website URL(必須)
マッピングしたい Web サイトのベース URL を入力します。
例:
* `https://example.com`
* `https://www.competitor-site.com`
* `https://docs.example.com`
ノードはこの URL を起点にドメインをクロールし、到達可能なすべてのページの検出を試みます。
URL を直接入力するか、`/` を使用して前の Workflow ステップの変数を挿入できます。
### Output Label
ノードの結果の名前を指定します。例:
* `sitemap`
* `site_urls`
* `mapped_pages`
このラベルは、後続のステップでサイトマップの出力を参照するために使用します。
## 詳細設定
**Advanced settings** を展開して、クロールの深さとフィルタリングを設定します。
### Search Query
キーワードでサイトマップの結果をフィルタリングできます。
例:
* `blog`
* `pricing`
* `case-study`
* `ai`
特定のトピックやサイトのセクションに一致する URL のみが必要な場合に便利です。
### Maximum Results
返される URL の数を制限します。
デフォルト: **100**
ユースケースに応じて、値を増減してください。
* 競合リサーチの場合は **100〜500**
* 大規模なコンテンツ監査の場合は **500〜2,000**
* 簡単なサンプリングや軽量な Workflow の場合は **10〜50**
## 出力
ノードは、整理された機械可読な形式で、構造化された URL のリストを返します。
各エントリには通常、次の内容が含まれます。
* ページの URL
* クロール中に検出された基本的なメタデータ
* 正規化され、重複が除去されたリンク
この出力は、次のノードで直接利用できます。
* [Web Page Scrape ノード](/ja-jp/agents/workflows/nodes/web-page-scrape)
* [Perplexity Search ノード](/ja-jp/agents/workflows/nodes/perplexity-search)
* [Prompt LLM ノード](/ja-jp/agents/workflows/nodes/prompt-llm)
* [Profound データノード](/ja-jp/agents/workflows/nodes/data/visibility-score)
* カスタムの分析ステップや抽出ステップ
## 使用例
### 1. 競合コンテンツの包括的な監査を行う
1. `https://competitor.com` を指定して **Get Sitemap** を追加します
2. ループまたはバッチ処理の Workflow を使用して、出力を [Web Page Scrape](/ja-jp/agents/workflows/nodes/web-page-scrape) に渡します
3. [Prompt LLM](/ja-jp/agents/workflows/nodes/prompt-llm) を使用してパターン(トピック、構成、ギャップなど)を分析します
4. リサーチレポートまたはサマリーを生成します
### 2. AEO のためのコンテンツギャップを特定する
1. **Get Sitemap** を使用して、自社サイトのすべてのページを一覧表示します
2. [Citation Pages](/ja-jp/agents/workflows/nodes/data/citation-pages) を使用して、どのページが引用されているかを確認します
3. [Prompt LLM](/ja-jp/agents/workflows/nodes/prompt-llm) を使用して、アンサーエンジンに表示されて **いない** ページを特定します
4. 推奨事項やコンテンツの改善案を生成します
### 3. 大規模なコンテンツ生成
1. サイトの URL を取得します
2. Search Query フィールドを使用してフィルタリングします(例: `/blog`)
3. 選択した URL を [Create Content Brief](/ja-jp/agents/workflows/nodes/content-creation/create-content-brief) または [Generate Article](/ja-jp/agents/workflows/nodes/content-creation/generate-article) のチェーンに渡します
4. 更新版または派生コンテンツを大規模に作成します
## ベストプラクティス
* 特に大規模なサイトでは、規模を拡大する前に、妥当な上限(例: 200 URL)から始めてください。
* コンテンツの一部のみが必要な場合は、**Search Query** を使用して結果を絞り込んでください。
* [Prompt LLM](/ja-jp/agents/workflows/nodes/prompt-llm) と組み合わせて、URL をクラスタリングまたは分類してください。
* 大規模なエンタープライズ Web サイトの場合は、異なる開始 URL(例: `/blog`、`/products`、`/docs`)を指定した複数の Get Sitemap ノードを実行してください。
* 複数のサイトマップ処理をチェーンする場合は、わかりやすい出力ラベルを使用してください。