

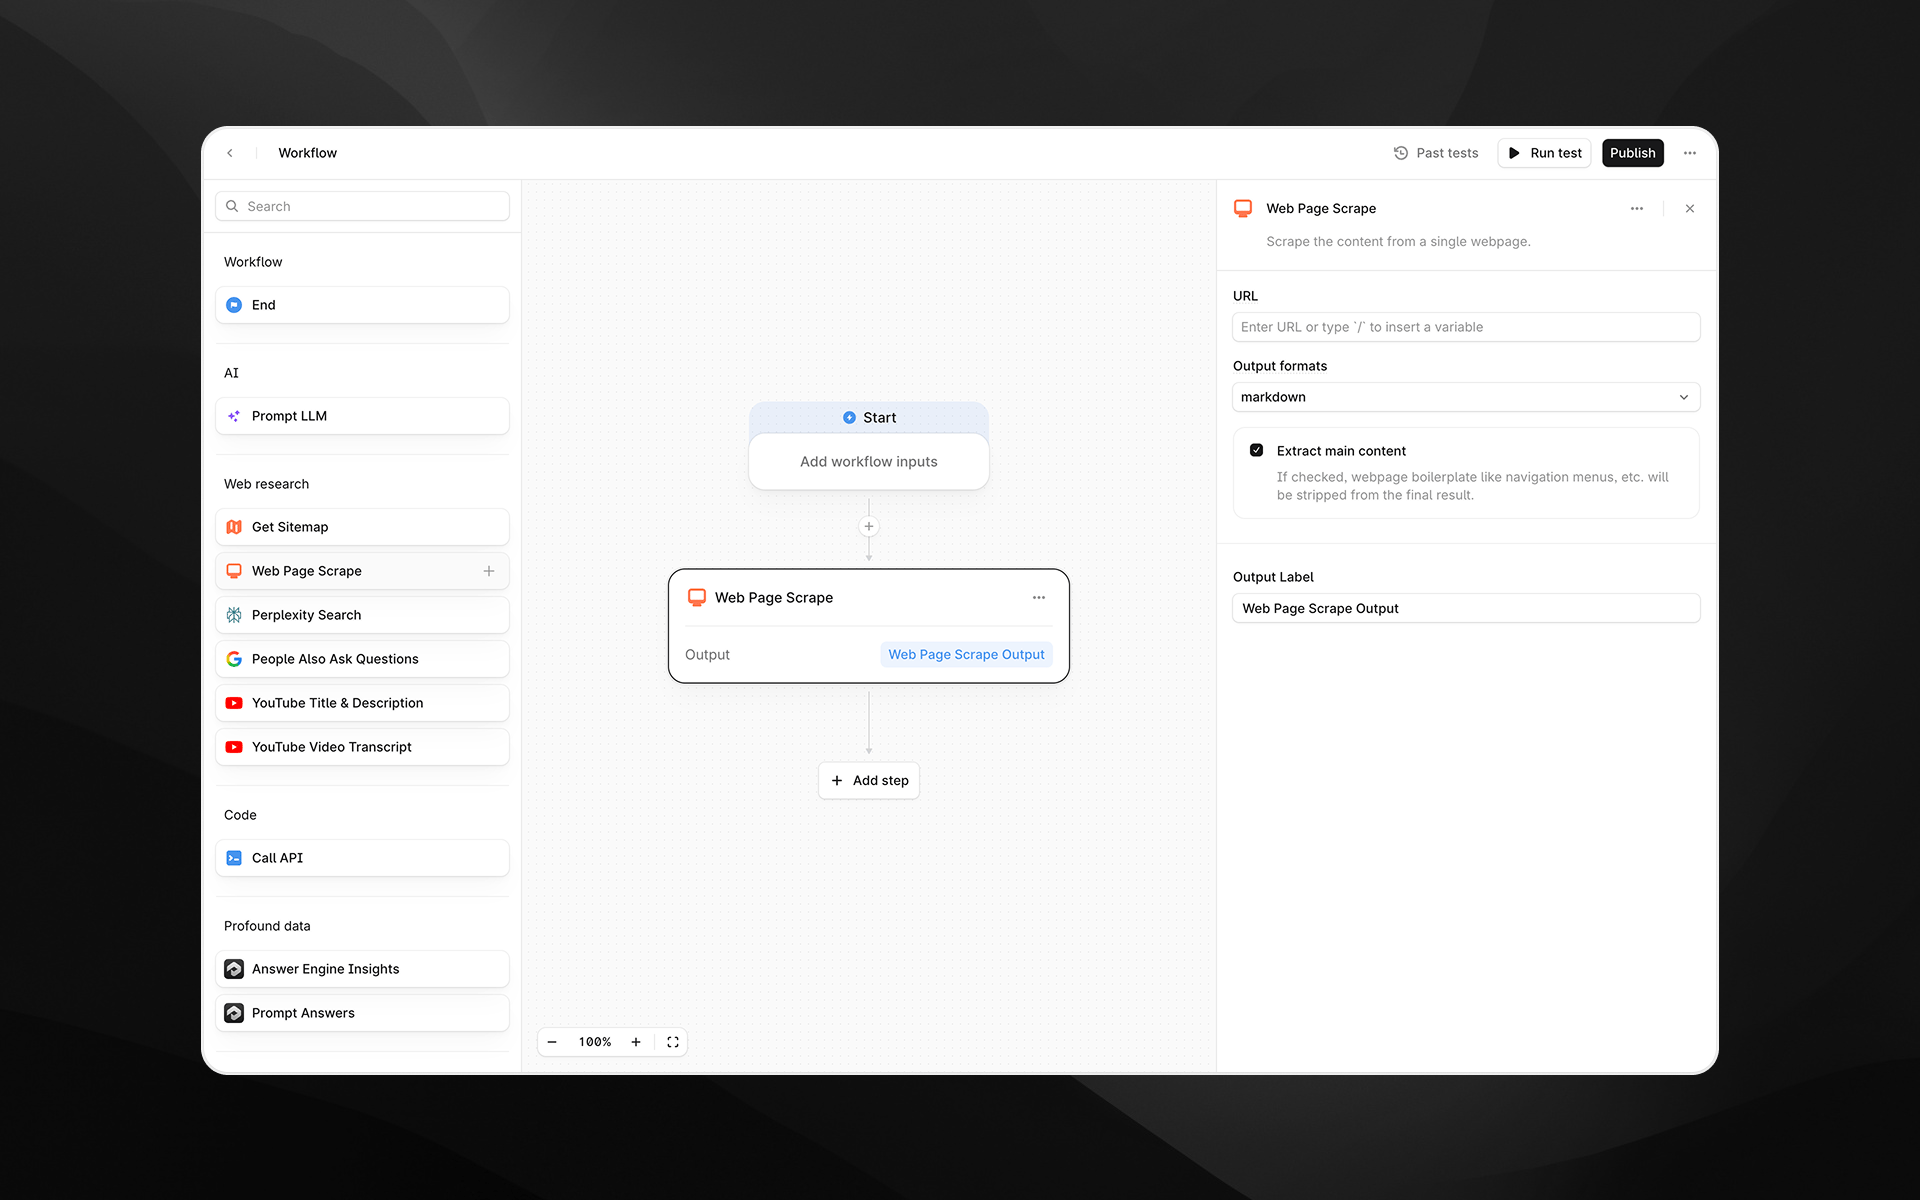
Cuándo usar este nodo
Usa Web Page Scrape para tareas como:- Recopilar contenido de artículos, landing pages, entradas de blog o documentación
- Extraer texto para resúmenes o análisis competitivos
- Obtener contenido estructurado para usarlo en prompts de LLM posteriores
- Normalizar el contenido de una página web antes de incorporarlo a otros pasos del Workflow
Configuración del nodo
Al seleccionar el nodo Web Page Scrape, se abre su panel de configuración en el lado derecho del Workflow Builder. Este nodo incluye los siguientes campos.URL (obligatorio)
Introduce la URL de la página web que quieres extraer. Puedes:- Pegar una URL estática, o
- Insertar una variable escribiendo
/para hacer referencia a entradas del Workflow o resultados de pasos anteriores
Render Output As
Elige el formato del contenido extraído. Opciones disponibles:- Markdown: devuelve texto limpio y legible, adecuado para el procesamiento con LLM
- HTML: devuelve la estructura HTML de la página
Extract main content
Cuando está activada, Profound intenta eliminar los elementos de navegación, anuncios, pies de página, texto repetitivo y otro contenido no esencial. Por lo general, esto da como resultado un contenido más limpio, centrado en el artículo o el cuerpo principal. Desactiva esta opción si necesitas el contenido completo de la página sin filtrar.Output Label
Proporciona una etiqueta descriptiva para el resultado de este paso. La etiqueta se convierte en el nombre de variable al que harás referencia en nodos posteriores del Workflow. Ejemplos:page_contentscraped_markdownraw_html
Resultado
Este nodo devuelve un único resultado de texto que contiene el contenido extraído de la página en el formato seleccionado. El resultado puede usarse en:- Pasos de Prompt LLM
- Nodos adicionales de investigación o análisis
- Llamadas a API
- Cualquier paso de transformación posterior
Ejemplos de uso
1. Extraer y resumir una página web
- Agrega un paso Web Page Scrape y establece la URL de la página que quieres analizar.
- Elige Markdown como formato de resultado.
- Agrega un paso Prompt LLM que haga referencia al contenido extraído:
2. Extraer datos estructurados del HTML
- Extrae la página con el formato html.
- Pasa el HTML a un paso Prompt LLM con instrucciones de extracción:
Prácticas recomendadas
- Usa el resultado en Markdown para obtener el texto más limpio y listo para IA.
- Activa Extract main content cuando trabajes con páginas de tipo artículo.
- Si la extracción falla, confirma que la URL sea de acceso público y no requiera autenticación.
- Mantén etiquetas de resultado claras y descriptivas para simplificar las referencias posteriores.
Solución de problemas
El contenido extraído está vacío o incompleto
Esto puede ocurrir si la página depende en gran medida del renderizado del lado del cliente o usa protección contra scraping. Prueba a cambiar al resultado html para obtener contenido más en bruto.Aparece texto repetitivo en el resultado
Asegúrate de que Extract main content esté activado para reducir el contenido innecesario.La URL contiene variables que no se resuelven
Escribe/ para insertar variables compatibles y evitar nombres de parámetros que no coincidan.